テキスト抽出で文字が正しく認識されない、または何も抽出されない
ZunShotは、Windowsに内蔵されているOCRエンジンを使用します。結果は、インストールされている認識言語と画像の品質によって変わります。
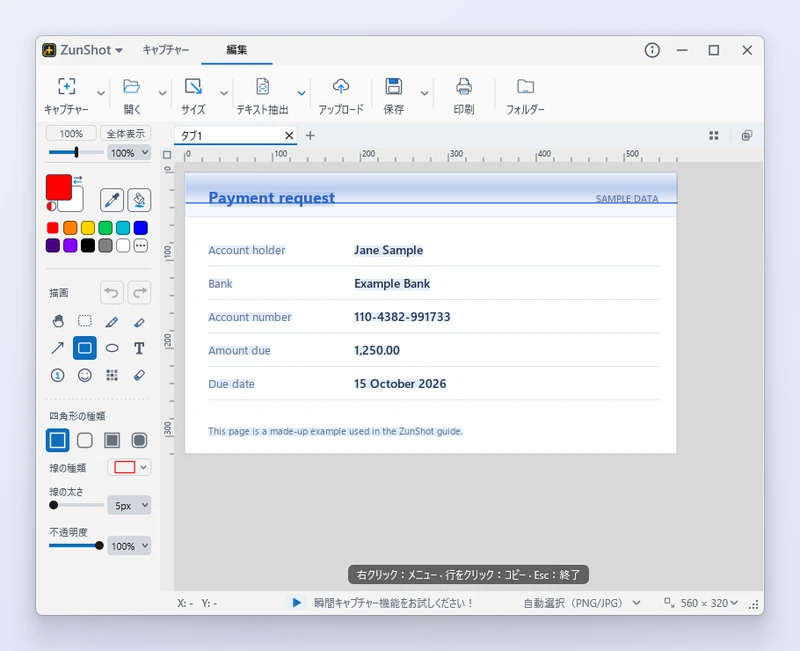
意味不明な文字になる
認識言語がテキストの言語と合っていません。テキスト抽出のパネルで適切な言語を選択してください。一覧にない場合は、設定 > 言語 > OCR言語をインストール…からインストールします。
言語をインストールしたのにOCRが失敗する
WindowsがOCRエンジンを登録するのは、表示言語だけでなく、その言語の「基本の入力」機能がインストールされている場合に限られます。Windowsの「設定」 > 時刻と言語 > 言語と地域を開き、対象の言語を選択して、「基本の入力」を追加してください。
何も認識されない
- 文字の高さが少なくとも約20ピクセルになるようにキャプチャーを拡大してから、もう一度抽出してください。
- テキストの周囲にある写真やアイコンを切り抜いて取り除いてください。
- 強く圧縮されたテキストや装飾的な書体のテキストは、読み取れない場合があります。
詳しくは、ガイドのテキスト抽出(OCR)をご覧ください。
すぐわかる回答
- OCRの結果が意味不明な文字になるのはなぜですか?
- 選択した言語がテキストの言語と合っていません。適切なWindowsのOCR言語を選択するか、インストールしてください。
- OCRのために画像がアップロードされますか?
- いいえ。認識は、WindowsのOCRエンジンを使ってPC上で行われます。